Artigo explicativo · apuração em 18/11/2026.
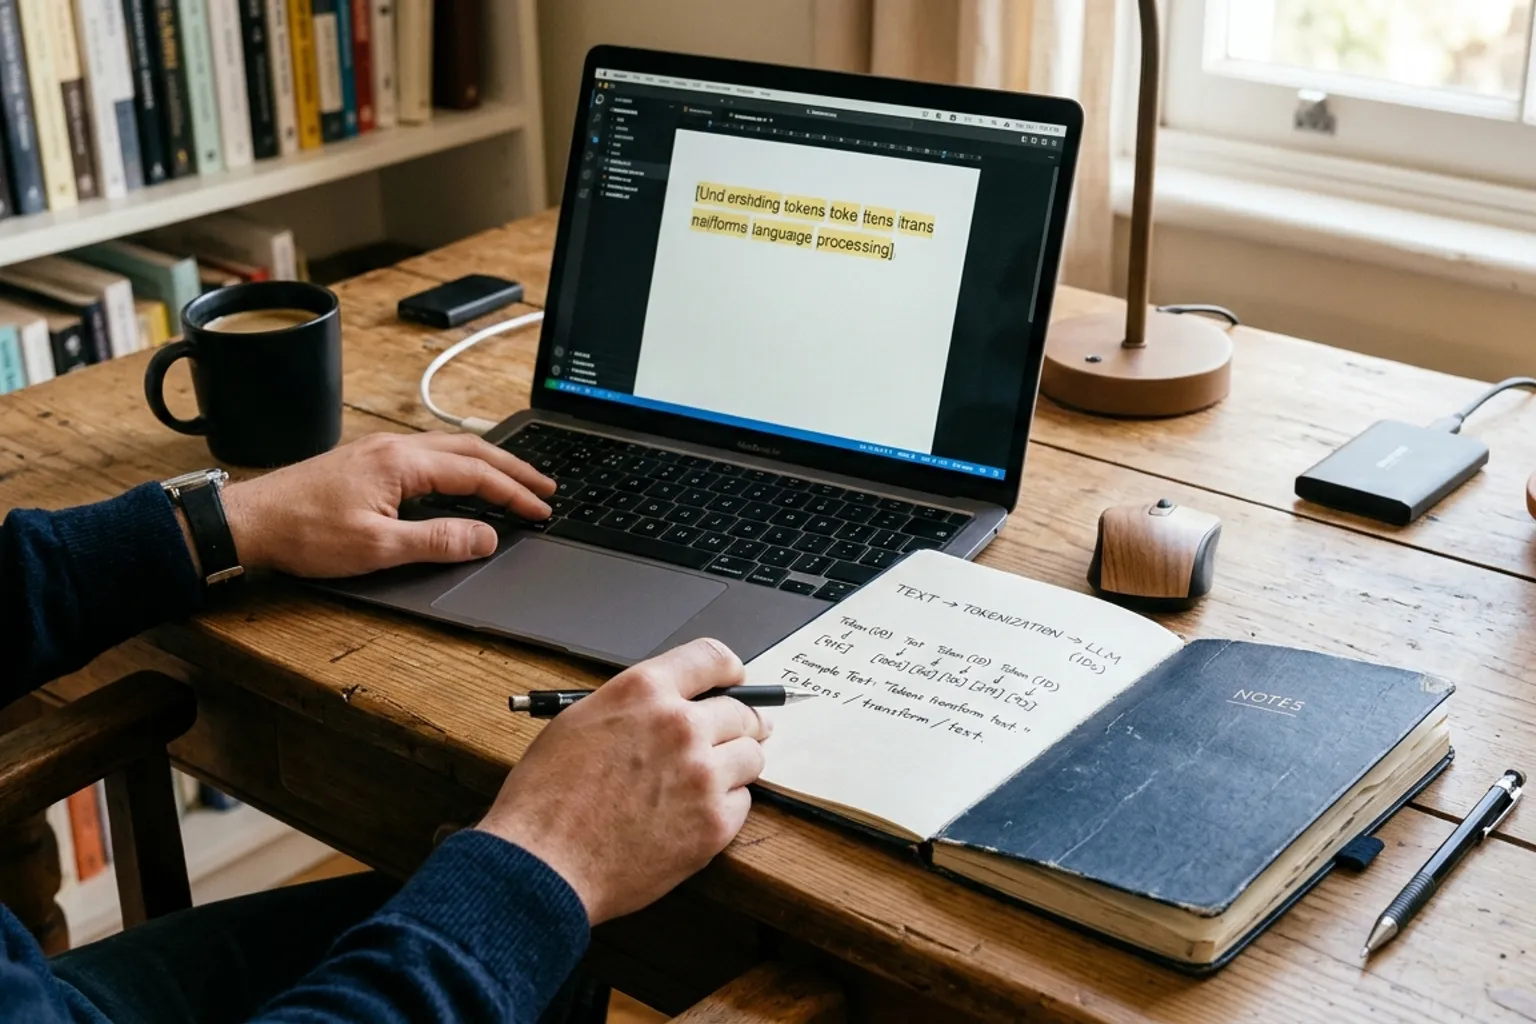
Tokens são as unidades de texto que modelos de linguagem de grande porte (LLMs, na sigla em inglês) processam. Um token pode corresponder a uma palavra inteira, a um trecho de palavra, a um sinal de pontuação ou até a um caractere; por isso, a divisão não coincide necessariamente com as palavras que uma pessoa vê na frase. [1] [2] [3]
Essa divisão é feita por um tokenizador, que transforma o texto em unidades de um vocabulário definido. Cada token recebe um identificador numérico, e o modelo trabalha com esses números, não diretamente com as letras do texto. Ao gerar uma resposta, produz identificadores de tokens, que depois são convertidos de volta em texto. [1] [3]
Com a entrada representada como tokens, o LLM prevê qual unidade vem a seguir - ou uma sequência delas - considerando o contexto anterior. A resposta é construída como uma continuação, token por token, e não como uma frase armazenada e recuperada pronta. [1] [2] [3]
Esse mecanismo ajuda a explicar tanto a geração de texto quanto seus limites: uma continuação plausível não garante que o conteúdo seja correto ou adequado. As fontes apontam riscos de alucinações, vieses e geração de conteúdo nocivo, além de custos de processamento; não especificam, porém, a magnitude desses riscos ou custos, que pode variar conforme o modelo e a aplicação. [1] [2]
Fontes: [1] LLM Fundamentals - https://learn.microsoft.com/en-us/agent-framework/journey/llm-fundamentals (data de publicação não informada) · consulta em 18/11/2026 [2] LLMs: What's a large language model? | Machine Learning | Google for Developers - https://developers.google.com/machine-learning/crash-course/llm/transformers (data de publicação não informada) · consulta em 18/11/2026 [3] What Are AI Tokens? The Language and Currency Powering Modern AI - https://blogs.nvidia.com/blog/ai-tokens-explained/ (2025-03-17) · consulta em 18/11/2026