Artigo explicativo · apuração em 14/11/2026.
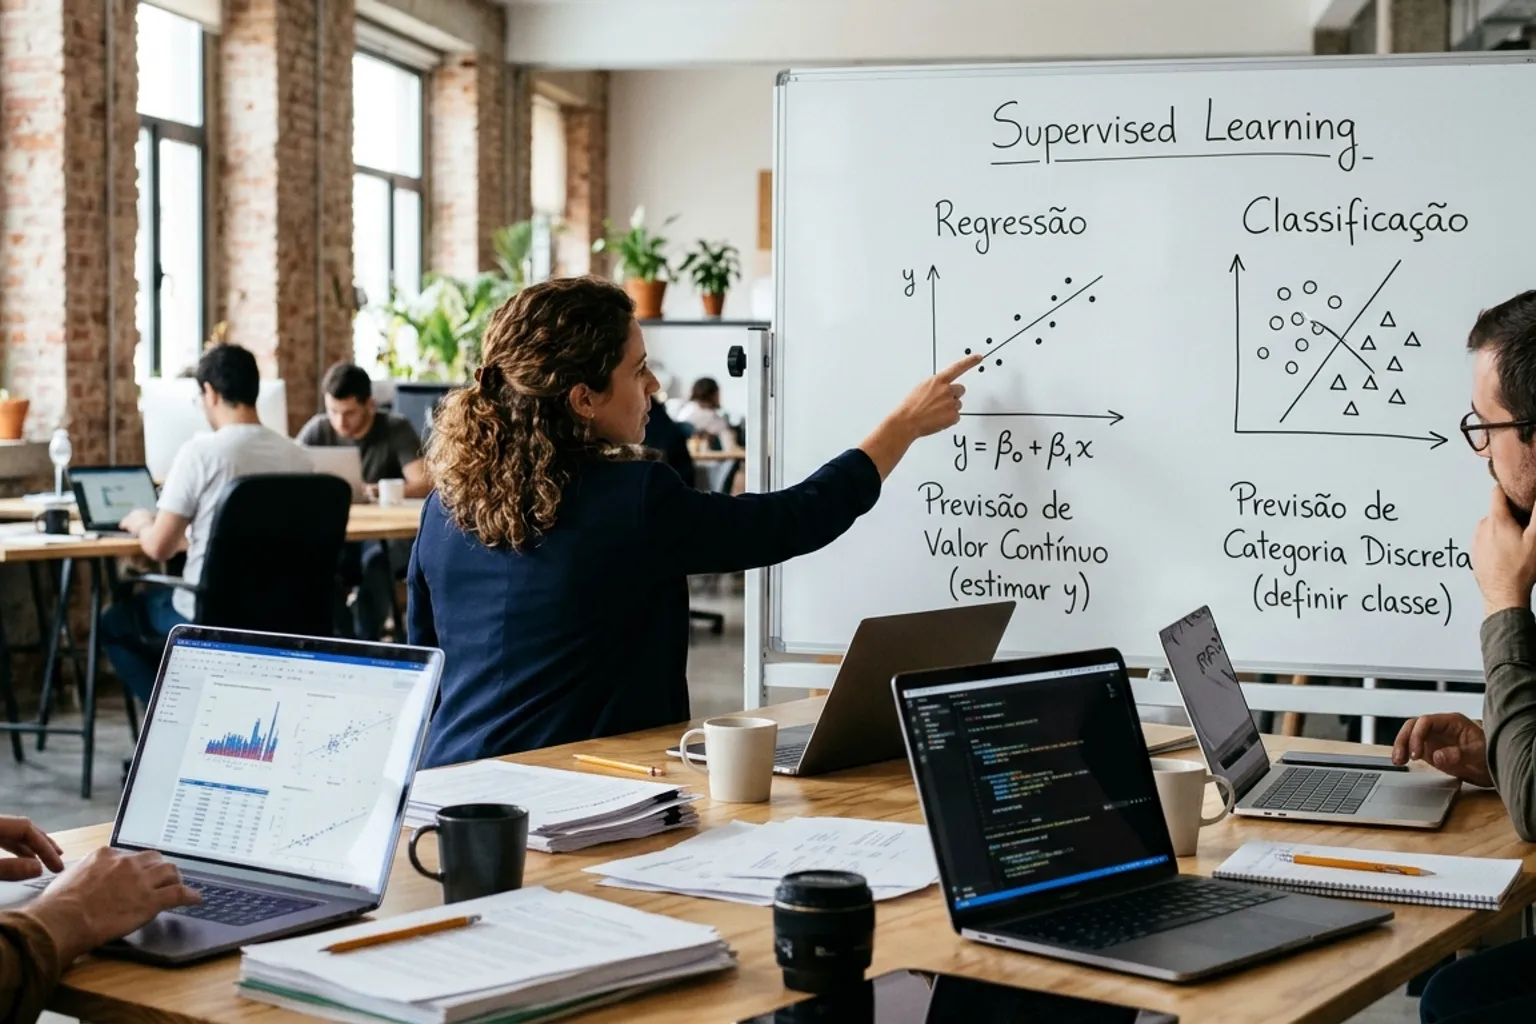
No aprendizado de máquina supervisionado, as tarefas de regressão e classificação se diferenciam fundamentalmente pelo formato da saída gerada. Enquanto a regressão é empregada para estimar valores numéricos a partir de características correlacionadas, os modelos de classificação atuam na atribuição de instâncias de dados a categorias ou classes predeterminadas. [1] [2]
O mecanismo da regressão lida com saídas que podem assumir valores reais contínuos, sem a restrição de pertencer a um conjunto finito e predeterminado. Em contrapartida, os algoritmos de classificação organizam as observações exclusivamente dentro de agrupamentos preestabelecidos, limitando as respostas a rótulos categóricos. [1] [2]
A classificação se divide principalmente em modalidades binárias e multiclasse, dependendo do número de grupos envolvidos. Na classificação binária, o modelo escolhe entre exatamente duas categorias possíveis, como a ocorrência ou não de um evento, enquanto a classificação multiclasse processa e distribui os dados entre mais de duas opções de classes. [1] [2]
Apesar dos resultados finais divergentes, tanto a regressão quanto a classificação compartilham o mesmo princípio operacional do aprendizado supervisionado. Ambos os métodos dependem do fornecimento de dados previamente rotulados, com exemplos de respostas conhecidas, para treinar os algoritmos e capacitar o sistema a projetar previsões precisas. [1] [2]
Fontes: [1] What is Machine Learning? | Google for Developers - https://developers.google.com/machine-learning/intro-to-ml/what-is-ml (data de publicação não informada) · consulta em 14/11/2026 [2] Machine learning tasks - ML.NET - https://learn.microsoft.com/en-us/dotnet/machine-learning/resources/tasks (data de publicação não informada) · consulta em 14/11/2026